1. Что такое llama-swap, vLLM и OpenWebUI
vLLM — это высокопроизводительный движок инференса больших языковых моделей, оптимизированный для максимальной пропускной способности и эффективного использования видеопамяти GPU. llama-swap — это легковесный прокси-сервер, который автоматически поднимает, останавливает и переключает модели «на лету» по запросу клиента, предоставляя единую точку входа в формате OpenAI API. OpenWebUI — это веб-интерфейс для общения с LLM, напоминающий по удобству ChatGPT, с поддержкой чатов, RAG, баз знаний и подключения внешних OpenAI-совместимых бэкендов. Связка этих трёх компонентов позволяет развернуть на одном сервере несколько моделей (в том числе LLM, embedding и rerank), гибко управлять их запуском и предоставить пользователям удобный веб-интерфейс. Благодаря llama-swap не нужно держать все модели в памяти GPU постоянно — они подгружаются по требованию и выгружаются после простоя.
2. Почему именно vLLM?
vLLM использует технологию PagedAttention для эффективного управления KV-cache, что даёт значительно более высокую пропускную способность как при параллельных, так и при единичных запросах по сравнению с Ollama и llama.cpp. В отличие от llama.cpp и Ollama, которые больше ориентированы на локальное использование и единичные запросы, vLLM изначально проектировался для production-нагрузок с множеством одновременных пользователей, поддержкой continuous batching, quantization (включая FP8) и speculative decoding. Для корпоративных сред это означает более предсказуемую производительность под нагрузкой, лучшую утилизацию GPU и встроенную поддержку OpenAI-совместимого API «из коробки».
3. Проверка видеокарт через nvidia-smi
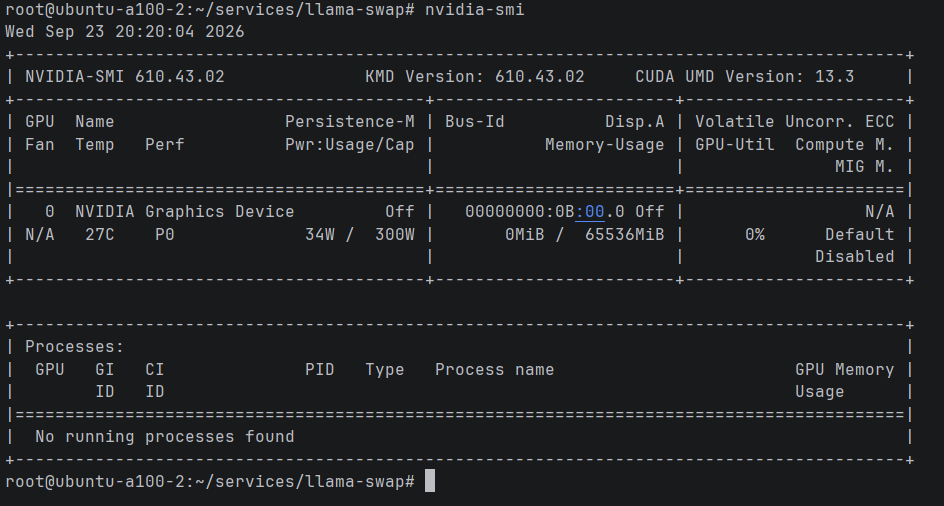
Перед началом установки необходимо убедиться, что драйвер NVIDIA корректно определяет видеокарту, и запомнить версию CUDA — она понадобится при выборе подходящего Docker-образа (CUDA-версия образа должна быть совместима с версией, поддерживаемой драйвером):
nvidia-smiВ выводе команды обратите внимание на поле CUDA Version в правом верхнем углу таблицы — именно это значение является верхней границей поддерживаемой версии CUDA для вашего драйвера:
4. Установка Docker на Ubuntu
Ниже — команды из официальной инструкции установки Docker Engine через apt.
4.1 Удаление конфликтующих (старых) пакетов
sudo apt remove $(dpkg --get-selections docker.io docker-compose docker-compose-v2 docker-doc docker-buildx podman-docker containerd runc | cut -f1)4.2 Добавление репозитория Docker в apt
sudo apt update
sudo apt install ca-certificates curl
sudo install -m 0755 -d /etc/apt/keyrings
sudo curl -fsSL https://download.docker.com/linux/ubuntu/gpg -o /etc/apt/keyrings/docker.asc
sudo chmod a+r /etc/apt/keyrings/docker.asc

sudo tee /etc/apt/sources.list.d/docker.sources <<EOF
Types: deb
URIs: https://download.docker.com/linux/ubuntu
Suites: $(. /etc/os-release && echo "${UBUNTU_CODENAME:-$VERSION_CODENAME}")
Components: stable
Architectures: $(dpkg --print-architecture)
Signed-By: /etc/apt/keyrings/docker.asc
EOF

sudo apt update
4.3 Установка Docker Engine и Docker Compose Plugin
sudo apt install docker-ce docker-ce-cli containerd.io docker-buildx-plugin docker-compose-plugin
5. Установка nvidia-container-toolkit + настройка Docker под NVIDIA
Установка выполняется по документации NVIDIA: https://docs.nvidia.com/datacenter/cloud-native/container-toolkit/latest/install-guide.html
5.1 Установка зависимостей
sudo apt-get update && sudo apt-get install -y --no-install-recommends \
   ca-certificates \
   curl \
   gnupg2
5.2 Подключение apt-репозитория NVIDIA Container Toolkit
curl -fsSL https://nvidia.github.io/libnvidia-container/gpgkey | sudo gpg --dearmor -o /usr/share/keyrings/nvidia-container-toolkit-keyring.gpg \
  && curl -s -L https://nvidia.github.io/libnvidia-container/stable/deb/nvidia-container-toolkit.list | \
    sed 's#deb https://#deb [signed-by=/usr/share/keyrings/nvidia-container-toolkit-keyring.gpg] https://#g' | \
    sudo tee /etc/apt/sources.list.d/nvidia-container-toolkit.list

sudo apt-get update
5.3 Установка пакетов nvidia-container-toolkit
В документации пример дан с фиксацией версии через переменную NVIDIA_CONTAINER_TOOLKIT_VERSION:
export NVIDIA_CONTAINER_TOOLKIT_VERSION=1.20.1-1
sudo apt-get install -y \
    nvidia-container-toolkit=${NVIDIA_CONTAINER_TOOLKIT_VERSION} \
    nvidia-container-toolkit-base=${NVIDIA_CONTAINER_TOOLKIT_VERSION} \
    libnvidia-container-tools=${NVIDIA_CONTAINER_TOOLKIT_VERSION} \
    libnvidia-container1=${NVIDIA_CONTAINER_TOOLKIT_VERSION}
5.4 Конфигурация Docker для работы с NVIDIA runtime
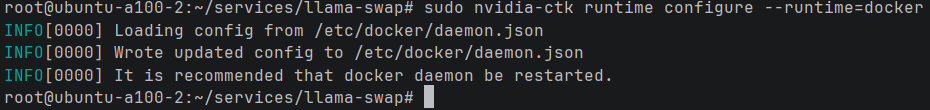
sudo nvidia-ctk runtime configure --runtime=docker
sudo systemctl restart docker
Успешное выполнение nvidia-ctk runtime configure --runtime=docker:
6. Подготовка среды
6.1 Создание каталогов и файлов
Создадим все необходимые для работы файлы и каталоги:
mkdir -p ~/services/llama-swap
cd ~/services/llama-swap
touch docker-compose.yml   # описание сервисов llama-swap и openwebui
touch config.yaml          # конфигурация моделей для llama-swap
touch Dockerfile           # инструкции сборки кастомного образа
6.2 Подготовка файлов для сборки и развёртывания
Dockerfile
Это «рецепт» сборки кастомного образа, который объединяет в себе два мира: бинарники llama-swap/llama.cpp (взятые из готового образа llama-swap:cuda13) и полноценное окружение vLLM (включая PyTorch и CUDA-библиотеки, подходящие именно под vLLM). Таким образом в одном контейнере становится доступен и vLLM, и llama.cpp, а llama-swap выступает диспетчером, который переключается между ними в зависимости от конфигурации модели:
# ============================================================
# llama-swap + llama.cpp CUDA 13
# ============================================================
FROM ghcr.io/mostlygeek/llama-swap:cuda13 AS llamaswap

# ============================================================
# vLLM + CUDA + PyTorch
# ============================================================
FROM vllm/vllm-openai:latest

# ============================================================
# llama-swap + llama.cpp
# ============================================================
COPY --from=llamaswap /app/ /app/

# CUDA compatibility libraries из оригинального образа
COPY --from=llamaswap \
    /usr/local/cuda-13.4/compat/ \
    /opt/llama-cuda/compat/

# NCCL из оригинального образа
COPY --from=llamaswap \
    /lib/x86_64-linux-gnu/libnccl.so.2 \
    /opt/llama-cuda/nccl/libnccl.so.2

# ============================================================
# Переменные окружения
# ============================================================
ENV PATH="/app:${PATH}"

# Только библиотеки llama.cpp — без CUDA compat
ENV LD_LIBRARY_PATH="/app:${LD_LIBRARY_PATH}"

# ============================================================
# Wrapper llama-server
# ============================================================
COPY llama-server-wrapper.sh /usr/local/bin/llama-server-wrapper

RUN chmod +x /usr/local/bin/llama-server-wrapper

# ============================================================
# Конфигурация
# ============================================================
COPY config.yaml /app/config.yaml

WORKDIR /app

EXPOSE 8080

ENTRYPOINT ["/app/llama-swap"]
CMD ["--config", "/app/config.yaml"]
docker-compose.yml
Этот файл описывает два сервиса: llama-swap (бэкенд с моделями) и openwebui (фронтенд для пользователей). Том ./config.yaml:/app/config.yaml позволяет редактировать конфигурацию моделей без пересборки образа — достаточно перезапустить контейнер. Остальные тома с кэшами (huggingface, vllm, torch, triton) нужны, чтобы при перезапуске контейнера не скачивать веса моделей и не пересобирать CUDA-кэши заново — это существенно ускоряет повторные запуски. Отдельно стоит отметить переменную HF_TOKEN: с указанным токеном Hugging Face снимаются ограничения по частоте запросов к их API, за счёт чего скачивание моделей проходит быстрее и стабильнее. Содержимое docker-compose.yml:
services:
  llama-swap:
    # Собираем образ из кастомного Dockerfile
    build: .
    container_name: llama_swap_vllm
    ports:
      - "3000:8080"
    environment:
      - NVIDIA_VISIBLE_DEVICES=0
      - NVIDIA_DRIVER_CAPABILITIES=all
      - NVIDIA_DISABLE_REQUIRE=true
      - TRITON_CACHE_DIR=/root/.triton/cache
      - TORCHINDUCTOR_CACHE_DIR=/root/.cache/torch/inductor
      - HF_TOKEN=<your token here>
    volumes:
      - ./cache/huggingface:/root/.cache/huggingface   # кэш скачанных моделей с HF
      - ./cache/vllm:/root/.cache/vllm                 # внутренний кэш vLLM
      - ./cache/torch:/root/.cache/torch                # кэш компиляции torch.inductor
      - ./cache/triton:/root/.triton                    # кэш скомпилированных Triton-кернелов
      - ./config.yaml:/app/config.yaml                  # конфигурация моделей
    deploy:
      resources:
        reservations:
          devices:
            - driver: nvidia
              count: 1
              capabilities: [gpu]
    restart: unless-stopped

  openwebui:
    image: ghcr.io/open-webui/open-webui:main
    container_name: open-webui
    depends_on:
      - llama-swap
    ports:
      - "8080:8080"
    volumes:
      - ./cache/openwebui:/app/backend/data
    environment:
      # обязательно задайте постоянный ключ (пример: openssl rand -hex 32)
      WEBUI_SECRET_KEY: "REPLACE_WITH_LONG_RANDOM_HEX"

      # подключаем llama-swap как OpenAI-compatible провайдера
      OPENAI_API_BASE_URL: "http://llama-swap:8080/v1"
      OPENAI_API_KEY: ""

      # для поддержки RAG (опционально). Настройки для embedding-модели
      RAG_EMBEDDING_ENGINE: "openai"
      RAG_EMBEDDING_MODEL: "embedding"
      RAG_OPENAI_API_BASE_URL: "http://llama-swap:8080/v1"
      RAG_OPENAI_API_KEY: ""

      # для поддержки RAG (опционально). Настройки для rerank-модели
      RAG_RERANKING_ENGINE: "external"
      RAG_RERANKING_MODEL: "rerank"
      RAG_EXTERNAL_RERANKER_URL: "http://llama-swap:8080/v1/rerank"
      RAG_EXTERNAL_RERANKER_API_KEY: ""

    restart: unless-stopped
Важно про WEBUI_SECRET_KEY: в production-окружении обязательно задавайте постоянное значение этого ключа (сгенерировать можно командой openssl rand -hex 32). Если оставить значение по умолчанию (генерируется случайно при каждом запуске), то при любом падении или перезапуске контейнера все пользователи будут разлогинены, так как токены сессий станут невалидными.
7. Выбор модели на Hugging Face
Необходимо зайти на huggingface.co и выбрать модель в формате safetensors — именно с этим форматом работает движок vLLM (в отличие от GGUF, используемого в llama.cpp). В нашем примере используется модель Qwen3.8-27B в квантовании FP8 (8 бит на вес с плавающей точкой) от команды Qwen: Qwen/Qwen3.8-27B-FP8. На странице модели важно запомнить название репозитория (в формате <организация>/<модель>) — оно будет использоваться в конфигурации config.yaml при запуске модели через vLLM. Репозиторий выбранной модели на Hugging Face:

8. Заполнение конфигурации и тестовый запуск
8.1 Конфигурация LLM
config.yaml
healthCheckTimeout: 900

models:
  main:
    name: Qwen3.8-27b-FP8
    ttl: 10800 #3 часа
    aliases:
      - qwen3.8-27b-fp8-vllm
    cmd: |
      vllm serve Qwen/Qwen3.8-27B-FP8
      --served-model-name main
      --hf-config-path Qwen/Qwen3.8-27B-FP8
      --tokenizer Qwen/Qwen3.8-27B-FP8
      --dtype bfloat16
      --quantization fp8
      --kv-cache-dtype bfloat16
      --gpu-memory-utilization 0.85
      --cpu-offload-gb 0
      --tensor-parallel-size 1
      --pipeline-parallel-size 1
      --max-model-len 131072
      --max-num-seqs 4
      --max-num-active-seqs 4
      --max-num-batched-tokens 16384
      --enable-chunked-prefill
      --enable-prefix-caching
      --long-prefill-token-threshold 8192
      --long-prefill-token-threshold-adaptive
      --performance-mode throughput
      --renderer-num-workers 4
      --host 127.0.0.1
      --port ${PORT}
      --uvicorn-log-level info

      --language-model-only
      --enable-per-request-metrics
      --enable-force-include-usage

      --per-request-spec-decode-metrics summary

      --enable-auto-tool-choice
      --tool-call-parser qwen3_coder

      --override-generation-config '{"presence_penalty": 1.5, "temperature": 0.7, "top_p": 0.80, "top_k": 20, "min-p": 0.0 }'
      --speculative-config '{"method": "mtp", "num_speculative_tokens": 3}'
      --default-chat-template-kwargs '{"enable_thinking": false}'
Пояснения к ключевым параметрам:
ttl: 10800— время (в секундах), по истечении которого llama-swap выгрузит модель из памяти при отсутствии запросов. Это освобождает VRAM, если модель долго не используется.--dtype bfloat16/--quantization fp8/--kv-cache-dtype bfloat16— веса модели хранятся в FP8 (экономия VRAM вдвое по сравнению с FP16/BF16), а вычисления и KV-cache ведутся в bfloat16 для сохранения точности.--gpu-memory-utilization 0.85— доля VRAM видеокарты, которую vLLM может занять под веса модели и KV-cache. Для GA100 CMP-170HX с 64 ГБ это значение выбрано так, чтобы оставить запас памяти под систему и другие сервисы (embedding/rerank модели).--max-model-len 131072— максимальная длина контекста модели (131к токенов), поддерживаемая Qwen3.8-27B.--max-num-seqs 4/--max-num-batched-tokens 16384— ограничивают число одновременно обрабатываемых последовательностей и суммарный батч токенов, балансируя между пропускной способностью и задержкой ответа.--enable-chunked-prefill/--enable-prefix-caching— ускоряют обработку длинных промптов и повторно используют уже вычисленный KV-cache для одинаковых префиксов запросов.--performance-mode throughput— режим приоритизации суммарной пропускной способности над задержкой одного запроса, что оптимально для сценариев с несколькими параллельными пользователями.--enable-auto-tool-choice/--tool-call-parser qwen3_coder— включают поддержку вызова инструментов (tool calling / function calling) с парсером, специфичным для семейства моделей Qwen3.--override-generation-config— переопределяет параметры сэмплирования по умолчанию (температура, top_p, top_k и т.д.) для более предсказуемой генерации.
Отдельно про speculative decoding (MTP): параметр --speculative-config '{"method": "mtp", "num_speculative_tokens": 3}' включает Multi-Token Prediction — технологию спекулятивного декодирования, которая заметно повышает скорость генерации на стадии decode. Однако за счёт этого активируются дополнительные («спекулятивные») слои модели, что увеличивает потребление VRAM. При 3 MTP-головах (num_speculative_tokens: 3) важно внимательно следить за процентом занятой видеопамяти — если он близок к пределу, возможно, придётся уменьшить контекстное окно.
Про распределение VRAM: при --gpu-memory-utilization 0.85 вся выделенная память делится между весами модели и KV-cache. Согласно логам запуска в нашей конфигурации размер KV-cache составил порядка 363 тыс. токенов, что при контексте 131072 токена даёт конкурентность около 2.77 — то есть одновременно можно обрабатывать практически 3 параллельных запроса максимальной длины. Если нужно увеличить конкурентность:
- уменьшите
num_speculative_tokensдо 2 — это освободит часть VRAM под KV-cache ценой некоторого снижения скорости генерации токенов; - либо увеличьте долю VRAM под KV-cache другим способом, не трогая MTP.
Если нужно увеличить контекстное окно (max-model-len), важно следить за процентом потребляемой VRAM, чтобы избежать ошибок OOM (Out Of Memory). Скорее всего, понадобится выделить больше памяти под KV-cache и, в крайнем случае, полностью отключить MTP. Также можно нарастить --gpu-memory-utilization, но при этом нужно помнить, что часть VRAM должна оставаться для других моделей (embedding, rerank) и для системных нужд.
Подробное описание всех параметров запуска доступно в официальной документации vLLM: https://docs.vllm.ai/en/latest/cli/serve — рекомендуем клиентам обращаться туда при возникновении вопросов по тонкой настройке.
8.2 Конфигурация embedding и rerank моделей (опционально, для RAG)
Эти модели не являются основным чат-ботом (unlisted: true скрывает их из списка в OpenWebUI), но используются внутренне для функций поиска по базе знаний (embedding) и переранжирования найденных фрагментов (rerank). Для них выделяется минимум VRAM (--gpu-memory-utilization 0.04), так как сами модели компактные, а режим interactivity приоритизирует низкую задержку ответа над пропускной способностью, что уместно для коротких embedding/rerank запросов.
config.yaml
models:
  embedding:
    unlisted: true
    ttl: 10800
    aliases:
      - bge-m3
    cmd: |
      vllm serve BAAI/bge-m3
      --host 127.0.0.1
      --port ${PORT}
      --served-model-name embedding
      --runner pooling
      --convert embed
      --dtype float16
      --max-model-len 4096
      --max-num-seqs 32
      --max-num-batched-tokens 8192
      --gpu-memory-utilization 0.04
      --performance-mode interactivity
      --renderer-num-workers 2

  rerank:
    unlisted: true
    ttl: 10800
    cmd: |
      vllm serve BAAI/bge-reranker-v2-m3
      --host 127.0.0.1
      --port ${PORT}
      --served-model-name rerank
      --runner pooling
      --convert classify
      --dtype float16
      --max-model-len 4096
      --max-num-seqs 32
      --max-num-batched-tokens 8192
      --gpu-memory-utilization 0.04
      --performance-mode interactivity
      --renderer-num-workers 2
8.3 Запуск и проверка работы
Запустите связку llama-swap + OpenWebUI командой:
docker compose up -d
При первом запуске произойдёт сборка образа из Dockerfile, после чего контейнеры запустятся. Проверить статус можно командой:
docker compose ps
Если статус обоих сервисов — Up, значит контейнеры успешно запущены. После этого сервисы доступны локально по адресам:
- llama-swap:
http://localhost:3000 - OpenWebUI:
http://localhost:8080
Для доступа из браузера извне необходимо добавить DNAT-правила в Edge VMware Cloud Director: выберите Edge виртуального датацентра, в котором создана ВМ, перейдите в раздел NAT и добавьте два DNAT-правила — для каждого из них укажите внешний IP, внешний порт, тип соединения TCP, внутренний IP (локальный адрес ВМ) и внутренний порт (3000 для llama-swap, 8080 для OpenWebUI), а также разрешённые Source Port и Source IP.
После настройки NAT-правил сервисы станут доступны в браузере по адресу http://{внешний IP}:{внешний порт}.
8.4 Включение поддержки llama.cpp в llama-swap (опционально)
Если клиенту помимо vLLM нужно запускать модели на движке llama.cpp (например, в формате GGUF), необходимо добавить в директорию ~/services/llama-swap скрипт-обёртку llama-server-wrapper.sh:
#!/bin/sh

export LD_LIBRARY_PATH="/opt/llama-cuda/compat:/opt/llama-cuda/nccl:/app:${LD_LIBRARY_PATH}"

exec /app/llama-server "$@"
Дело в том, что кастомный образ изначально собирается на базе окружения vLLM, поэтому по умолчанию переменная LD_LIBRARY_PATH указывает на CUDA-библиотеки, совместимые с vLLM, но не подходящие для llama.cpp. Этот скрипт переопределяет порядок поиска библиотек, указывая llama.cpp использовать совместимые с ним CUDA-библиотеки в первую очередь. Без этого скрипта llama.cpp будет завершаться с ошибкой из-за попытки использовать несовместимые CUDA-библиотеки, предназначенные для vLLM.
После добавления скрипта соответствующую модель в config.yaml необходимо запускать через llama-server-wrapper вместо прямого вызова llama-server, указав путь к GGUF-файлу модели и нужные параметры запуска.
8.5 Возможности RAG в интерфейсе OpenWebUI
OpenWebUI поддерживает как подключение внешних источников знаний, так и создание локальных баз знаний непосредственно в интерфейсе.
Интерфейс входа:

Главная страница чата:

Настройка внешних источников знаний выполняется в разделе Настройки → Админ → Интеграции → Внешние источники знаний:

Имеется возможность создания и использования нативных баз знаний OpenWebUI (локальная загрузка документов в базу, последующий выбор базы в чате при помощи #). Для этого необходимо перейти в раздел Рабочее пространство → Знания → Создать:

Добавление файлов в создаваемую нативную базу знаний:
Поиск по созданной базе знаний:

Примечание: по умолчанию функционал создания и настройки баз знаний доступен только пользователям роли "Администратор", но при желании есть возможность предоставить доступ отдельным пользователям.
9. Показатели инференса
По результатам тестирования связки на GA100 CMP-170HX 64 ГБ с моделью Qwen3.8-27B-FP8 получены следующие показатели скорости:
- Prefill (обработка входного промпта): примерно 1800–2000 токенов/сек.
- Decode (генерация ответа): в среднем 75–90 токенов/сек. При параллельных запросах или при генерации коротких ответов возможны просадки до 50–70 токенов/сек. На отдельных задачах, напротив, может наблюдаться прирост скорости до 100–130 токенов/сек.
